ResumenResumen
Este ensayo examina cinco pasos estratégicos para la creación y adopción de inteligencia artificial (IA) en Ecuador desde una perspectiva del Sur Global: la inversión en infraestructura digital y de cómputo, el aprovechamiento de modelos de peso abierto, la adaptación de la IA al contexto local mediante datos soberanos, la formación de talento humano y la cooperación internacional orientada a la opcionalidad tecnológica. A partir del análisis de un documento de referencia sobre IA de código abierto y de la literatura sobre colonialismo digital, extractivismo de datos y soberanía tecnológica, se sostiene que Ecuador no necesita competir en la construcción de modelos de frontera para participar de manera significativa en la economía de la IA. Se propone, además, la creación de un clúster nacional de IA orientado a la inferencia, como respuesta al costo, la latencia y la dependencia que implica servir modelos desde el exterior. Sin embargo, se advierte que la adopción de modelos abiertos y de infraestructura local no garantiza por sí misma la autonomía: sin gobernanza de datos, capacidades institucionales y diversificación de proveedores, el país corre el riesgo de reproducir dependencias bajo una apariencia de soberanía. El ensayo concluye con una hoja de ruta escalonada y con recomendaciones de política pública.
Palabras clave: inteligencia artificial, Ecuador, Sur Global, modelos de peso abierto, soberanía tecnológica, colonialismo digital
Sección 1Introducción
La expansión acelerada de la inteligencia artificial (IA) durante la última década ha reabierto un debate clásico de las ciencias sociales latinoamericanas: quién produce el conocimiento, quién controla la infraestructura que lo hace posible y quién se apropia de los beneficios. La IA generativa, en particular, ha concentrado capacidades de cómputo, datos y talento en un reducido número de corporaciones y Estados, de modo que la distribución de sus ventajas reproduce, y en algunos aspectos profundiza, las asimetrías existentes entre el Norte y el Sur Global. La adopción de esta tecnología ha evidenciado una marcada brecha: las naciones de altos ingresos se benefician de manera desproporcionada de los avances, mientras que los países de ingresos bajos y medios quedan rezagados (IA de código abierto, s. f.).
No obstante, la misma tecnología ofrece una oportunidad inédita para que las naciones en desarrollo aborden desafíos que durante décadas han resistido soluciones convencionales, como el diagnóstico temprano de enfermedades en territorios con escasez de especialistas, la productividad de las pequeñas y medianas empresas o la eficiencia de los servicios públicos. La pregunta relevante para un país como Ecuador no es, por tanto, si debe adoptar la IA, sino bajo qué condiciones lo hará: como consumidor pasivo de servicios diseñados en otras latitudes o como actor con capacidad de adaptar, gobernar y, cuando corresponda, crear tecnología propia.
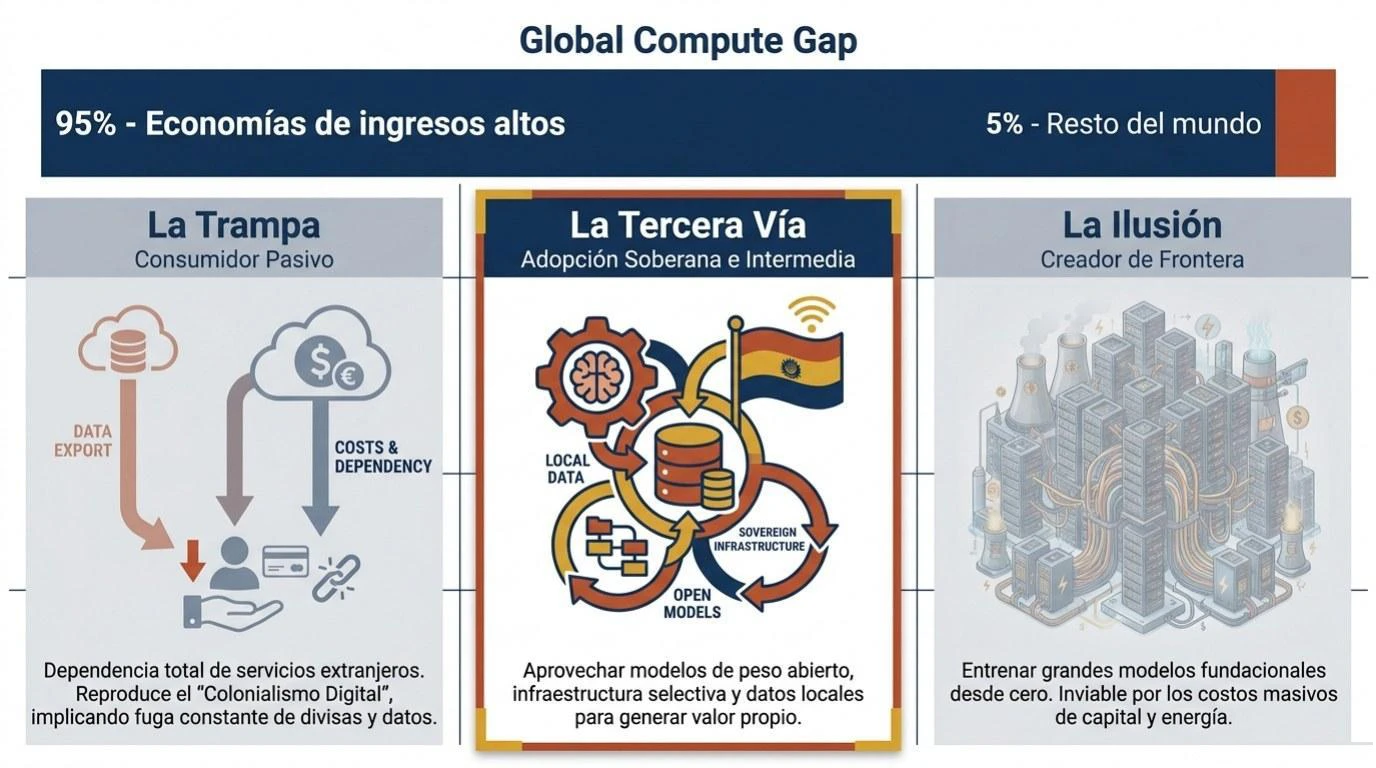
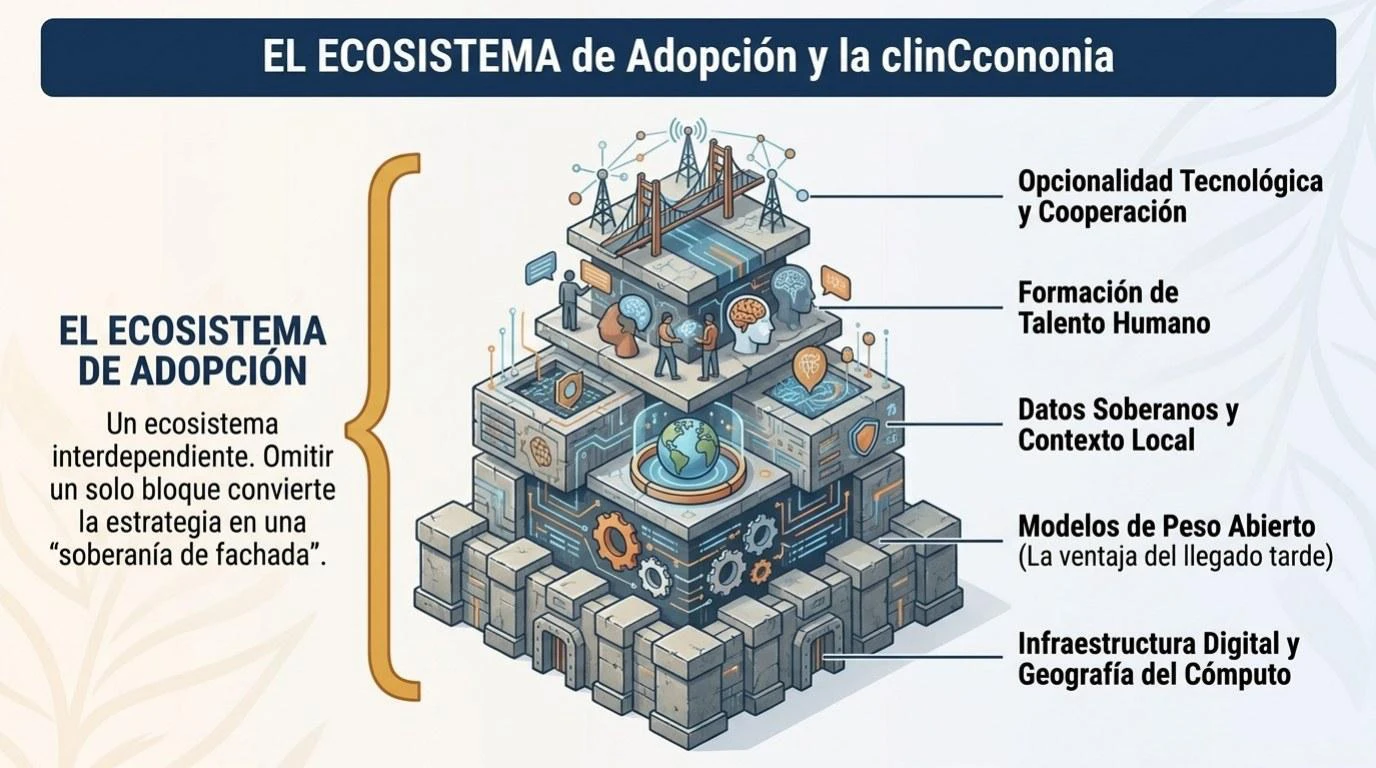
Este ensayo sostiene que existe un camino intermedio y viable entre la dependencia total y la aspiración, poco realista en el corto plazo, de entrenar modelos de frontera desde cero. Ese camino consiste en aprovechar los ecosistemas de IA de código y pesos abiertos, invertir de manera selectiva en infraestructura, emplear datos propios bajo jurisdicción nacional, formar talento humano y diversificar deliberadamente los proveedores tecnológicos. A partir de un documento de referencia sobre IA de código abierto como oportunidad para el Sur Global (IA de código abierto, s. f.), se desarrollan cinco pasos esenciales, complementados con la propuesta de un clúster nacional de inferencia, que se analizan con el respaldo de la literatura académica y se contrastan con el contexto ecuatoriano.
El argumento se articula en tres movimientos. En primer lugar, se establece un marco conceptual que integra los aportes sobre colonialidad del poder, colonialismo digital y extractivismo de datos, con el fin de evitar una lectura ingenuamente tecnocrática de la adopción de IA. En segundo lugar, se examinan los cinco pasos propuestos, discutiendo para cada uno sus fundamentos, sus condiciones de posibilidad y sus riesgos. En tercer lugar, se problematiza la noción misma de soberanía tecnológica, advirtiendo sobre la posibilidad de una soberanía meramente nominal, y se propone una hoja de ruta integrada. El ensayo adopta, así, una postura deliberadamente propositiva sin renunciar al examen crítico: la crítica sin propuesta conduce a la parálisis, y la propuesta sin crítica, a la reproducción de las dependencias que se pretende superar.
nacional de inferencia
Sección 2Marco conceptual: colonialidad, extractivismo de datos y soberanía tecnológica
Cualquier reflexión sobre la creación y adopción de IA en el Sur Global exige un marco que permita comprender las relaciones de poder que atraviesan la tecnología. La noción de colonialidad del poder formulada por Quijano (2000) sostiene que la clasificación jerárquica del mundo instaurada durante la conquista europea sobrevivió al fin del colonialismo formal y continúa organizando la economía, el conocimiento y la subjetividad. Aplicada al campo digital, esta perspectiva permite interpretar la concentración contemporánea de datos, plataformas y capacidad de cómputo como una reconfiguración de asimetrías históricas y no como un simple resultado de la eficiencia del mercado.
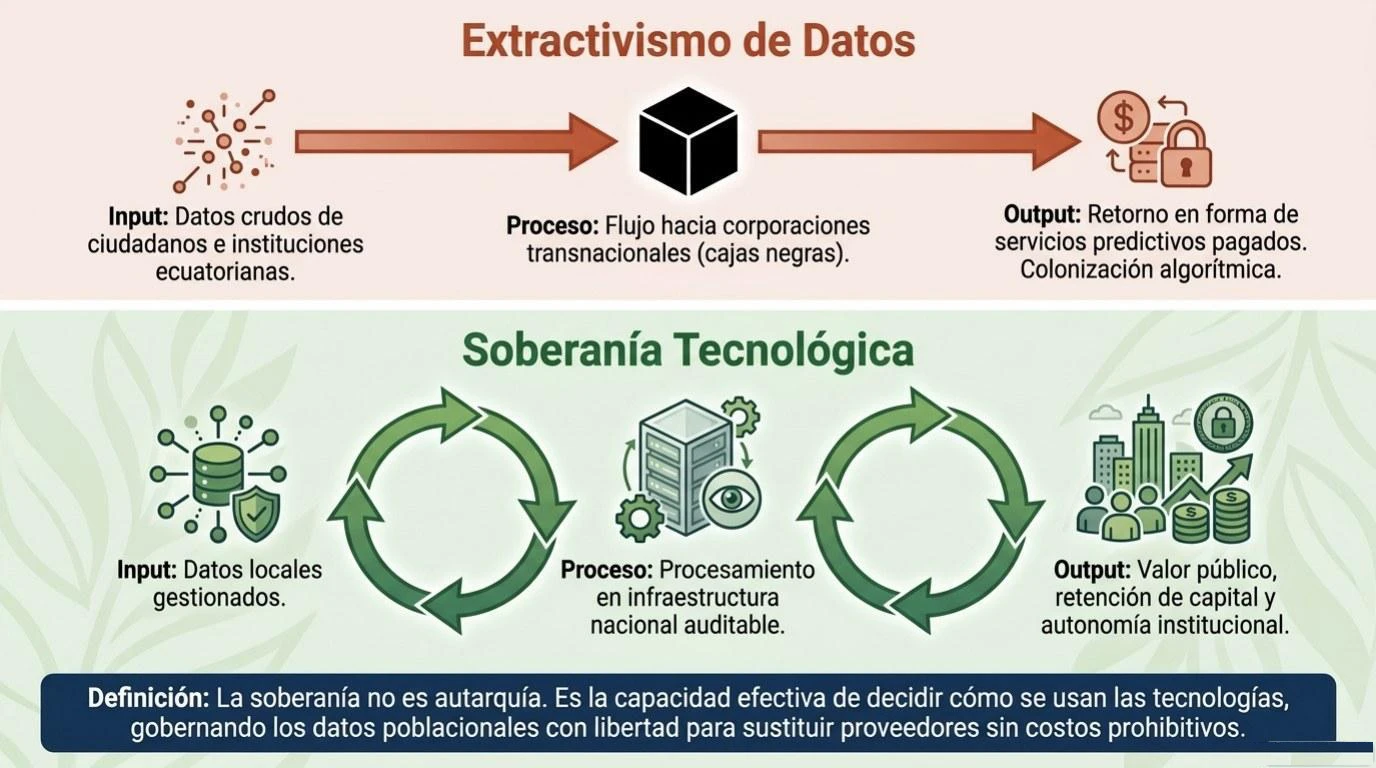
En esa línea, Couldry y Mejias (2019) proponen el concepto de colonialismo de datos para describir una nueva fase del capitalismo en la que la vida humana es convertida en insumo extraíble mediante la captura continua de datos personales y sociales. Su tesis es que esta apropiación es comparable, en su lógica de fondo, con la apropiación colonial de tierras y recursos: se declara «disponible» aquello que antes no era mercancía y se organiza un orden social en torno a su extracción. Zuboff (2019), desde el análisis del capitalismo de vigilancia, coincide en que los datos de comportamiento constituyen una materia prima cuya expropiación alimenta modelos predictivos comercializables. Srnicek (2017), por su parte, subraya que las plataformas se configuran como infraestructuras que extraen y monopolizan datos, lo que explica su tendencia a la concentración.
Kwet (2019) ha llevado este argumento al terreno geopolítico al hablar de colonialismo digital: el dominio, por parte de un pequeño grupo de potencias y corporaciones, de la arquitectura digital sobre la que operan las sociedades del Sur Global, incluyendo el software, el hardware y las redes. Ávila Pinto (2018) advierte que esta dependencia no es solamente económica, sino que compromete la capacidad de los Estados de garantizar derechos, dado que la infraestructura de la que dependen los servicios públicos está en manos de actores sobre los que carecen de control efectivo. Birhane (2020) documenta cómo, en el caso africano, la importación acrítica de sistemas algorítmicos diseñados en el Norte genera lo que denomina una colonización algorítmica, en la que las comunidades son tratadas como campos de experimentación y fuentes de datos, antes que como sujetos de decisión.
Desde América Latina, Ricaurte (2019) ha desarrollado el concepto de epistemologías de datos para mostrar que los regímenes de datos no son neutrales, sino que codifican formas de conocer y de valorar que suelen desplazar los saberes locales. La reflexión se conecta con la propuesta de Santos (2014) sobre las epistemologías del Sur y el epistemicidio, entendido como la destrucción sistemática de saberes no hegemónicos. En el campo específico de la IA, Mohamed et al. (2020) proponen una IA decolonial, entendida como una prospectiva sociotécnica que exige atender de manera explícita a las relaciones de poder que atraviesan el diseño, el despliegue y la gobernanza de los sistemas inteligentes.
Este acervo teórico introduce una cautela indispensable para el análisis de los cinco pasos que se examinan más adelante. Si la IA es un espacio de disputa de poder, entonces las decisiones técnicas sobre infraestructura, modelos, datos, talento y alianzas son también decisiones políticas. Una estrategia de adopción que se limite a maximizar la eficiencia técnica puede, paradójicamente, consolidar dependencias estructurales. Por ello, el concepto de soberanía tecnológica que se emplea en este ensayo no equivale a autarquía ni a la fabricación nacional de cada componente de la cadena de valor. Se entiende, más bien, como la capacidad efectiva de un país para decidir cómo se usan las tecnologías que emplea, bajo qué reglas se tratan los datos de su población y con qué margen puede sustituir a sus proveedores sin costos prohibitivos. Esta definición, de carácter operativo, permite evaluar cada paso a partir de una pregunta común: ¿aumenta o reduce la capacidad de decisión del Estado, las instituciones y la ciudadanía ecuatorianos?
Sección 3La brecha global de la IA y la geografía del cómputo
La desigualdad en el acceso a la IA no es una abstracción. Tiene una expresión material en la ubicación de los centros de datos, los semiconductores y las redes de fibra que sostienen el entrenamiento y la inferencia de los modelos. De acuerdo con el documento de referencia, el 95 % de la capacidad global de centros de datos se concentra en economías de ingresos altos y medio- altos, mientras que los países de ingresos bajos y medio-bajos representan solamente alrededor del 5 % (IA de código abierto, s. f.). Esta cifra sintetiza una realidad estructural: el poder de cómputo, insumo fundamental de la IA contemporánea, está distribuido de manera radicalmente desigual.
La concentración no se limita al hardware. Bommasani et al. (2021) describen el surgimiento de los modelos fundacionales, entrenados con volúmenes masivos de datos y adaptables a múltiples tareas, y advierten que su desarrollo exige recursos que solo un número reducido de organizaciones puede movilizar, lo cual genera un riesgo de homogeneización y de dependencia de unos pocos puntos de falla. Bender et al. (2021), a su vez, señalan que el tamaño creciente de los modelos de lenguaje tiene costos ambientales y sociales, y que los conjuntos de datos empleados tienden a sobrerrepresentar a las poblaciones con mayor presencia en internet, lo que refuerza sesgos y excluye lenguas y perspectivas minoritarias.
Para Ecuador, esta geografía tiene consecuencias concretas. El país es hispanohablante y multilingüe, con lenguas como el kichwa y el shuar que cuentan con escasa representación en los corpus de entrenamiento globales. Su tejido productivo está compuesto en gran medida por micro, pequeñas y medianas empresas, con capacidades limitadas para negociar con proveedores tecnológicos transnacionales. Y su Estado enfrenta restricciones fiscales que dificultan las inversiones de gran escala. Estas condiciones podrían conducir a una lectura fatalista, según la cual el país está condenado a ser un consumidor de tecnología ajena. Sin embargo, la propia literatura sobre desarrollo ofrece un contrapunto útil. Gerschenkron (1962) sostuvo que el rezago económico puede convertirse, bajo ciertas condiciones, en una ventaja, porque los países que llegan tarde pueden adoptar tecnologías ya maduras sin pasar por las fases costosas de experimentación. La cuestión es identificar las condiciones institucionales para que esa ventaja se materialice y no se disuelva en nuevas formas de subordinación.
El documento de referencia se sitúa precisamente en esa perspectiva al sugerir que los países del Sur Global disponen de opciones viables para sortear las altas barreras de entrada, y que construir un ecosistema de IA no requiere necesariamente replicar el camino de las grandes potencias (IA de código abierto, s. f.). Los cinco pasos que se analizan a continuación organizan esas opciones en una secuencia lógica, aunque, como se verá, no estrictamente lineal: varios de ellos deben avanzar en paralelo y se refuerzan mutuamente.
Sección 4Paso 1: inversión en infraestructura digital y de cómputo
El primer paso consiste en asegurar el acceso a la infraestructura física necesaria, es decir, los centros de datos, la conectividad y la potencia de cómputo (IA de código abierto, s. f.). Sin esta base material, cualquier estrategia de IA queda sujeta a la disponibilidad y las condiciones comerciales de proveedores externos. La infraestructura es, además, el primer terreno donde se juega la soberanía: quien aloja los datos y ejecuta los modelos determina las condiciones de acceso, de privacidad y de continuidad del servicio.
Ecuador registra avances concretos en este ámbito. Según el documento de referencia, Telconet, un operador de telecomunicaciones líder en el país, ha desplegado una fábrica de IA destinada a apoyar casos de uso locales, entre ellos la seguridad urbana (IA de código abierto, s. f.). Este desarrollo es significativo por dos razones. Primero, demuestra que la inversión privada nacional puede jugar un papel relevante en la construcción de capacidad de cómputo. Segundo, indica que existe una demanda real de aplicaciones de IA ejecutadas en territorio ecuatoriano. No obstante, el mismo ejemplo sugiere una cautela: cuando la infraestructura se orienta primordialmente a aplicaciones de seguridad y vigilancia, es imprescindible establecer marcos de gobernanza que eviten que la capacidad instalada se convierta en un instrumento de control sin salvaguardas democráticas.
La inversión en infraestructura debe evitar, además, dos errores frecuentes. El primero es la sobredimensión: construir capacidad de cómputo de frontera sin una demanda que la justifique ni un plan de sostenibilidad económica y energética. El segundo es la subdimensión: confiar exclusivamente en servicios de nube extranjeros para todas las cargas de trabajo, incluso aquellas que involucran datos sensibles del Estado o de la ciudadanía. Un enfoque razonable consiste en una arquitectura escalonada, en la que las cargas críticas y los datos sensibles se procesan en infraestructura ubicada en territorio nacional, mientras que las cargas de propósito general pueden apoyarse en proveedores globales bajo contratos que garanticen portabilidad y salvaguardas jurídicas.
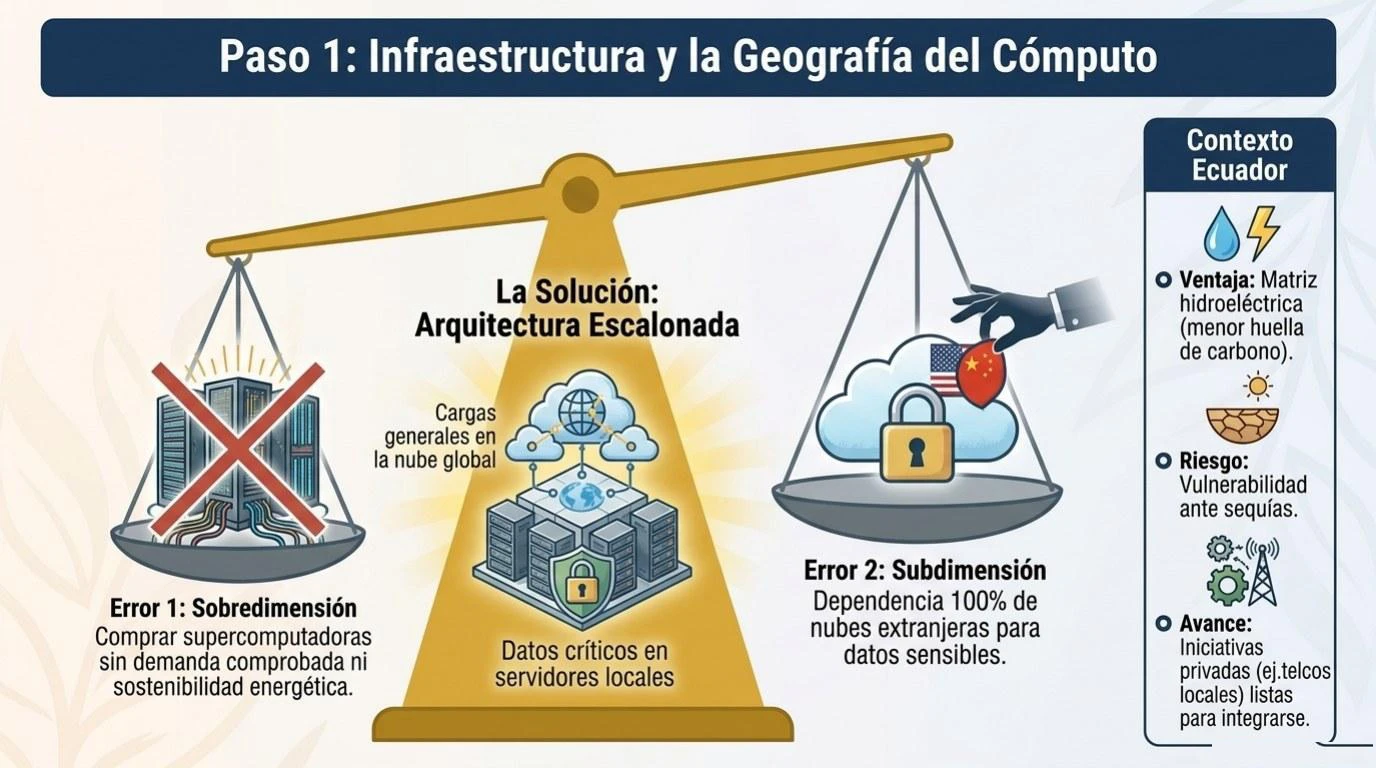
La sostenibilidad energética constituye otra variable ineludible. Ecuador cuenta con una matriz eléctrica de elevada participación hidroeléctrica, lo que representa una ventaja comparativa potencial para alojar cómputo intensivo con menor huella de carbono. Esa ventaja, sin embargo, depende de la estabilidad del suministro, de la gestión de sequías que han afectado la generación en años recientes y de una planificación que compatibilice la demanda de los centros de datos con las necesidades de la población. Bender et al. (2021) recuerdan que los costos ambientales de la IA no son externalidades menores, y que las decisiones sobre dónde y cómo entrenar modelos tienen implicaciones éticas.
En términos de política pública, este primer paso demanda tres líneas de acción. La primera es un mapeo nacional de la capacidad instalada y de los cuellos de botella, que permita identificar sinergias entre operadores privados, universidades y entidades públicas. La segunda es la adopción de esquemas de compra pública que exijan localización de datos sensibles, interoperabilidad y cláusulas de salida. La tercera es la promoción de modelos de cómputo compartido, mediante los cuales universidades, centros de investigación y pequeñas empresas puedan acceder a recursos que individualmente no podrían costear. La lógica de la minga, entendida como trabajo colectivo orientado a un bien común, ofrece una metáfora institucional apropiada para esta forma de coordinación.
Sección 5Clúster nacional de IA para inferencia: resolver el cuello de botella del despliegue
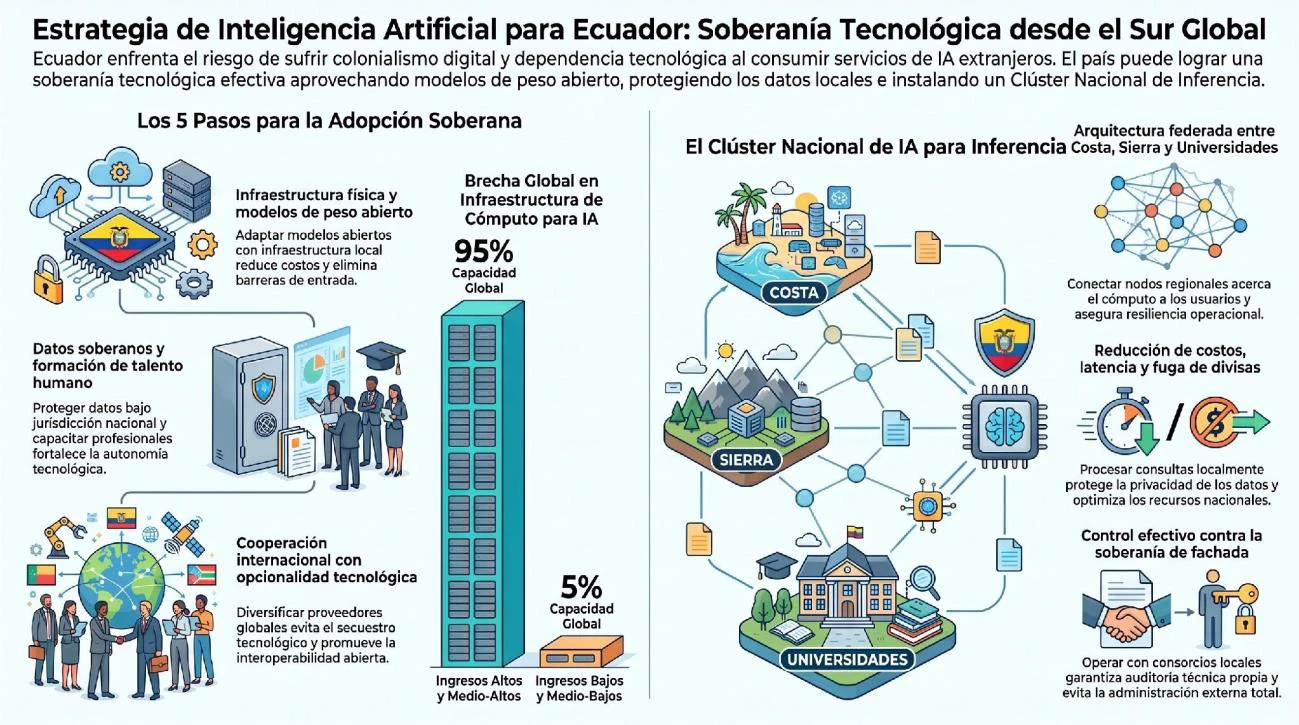
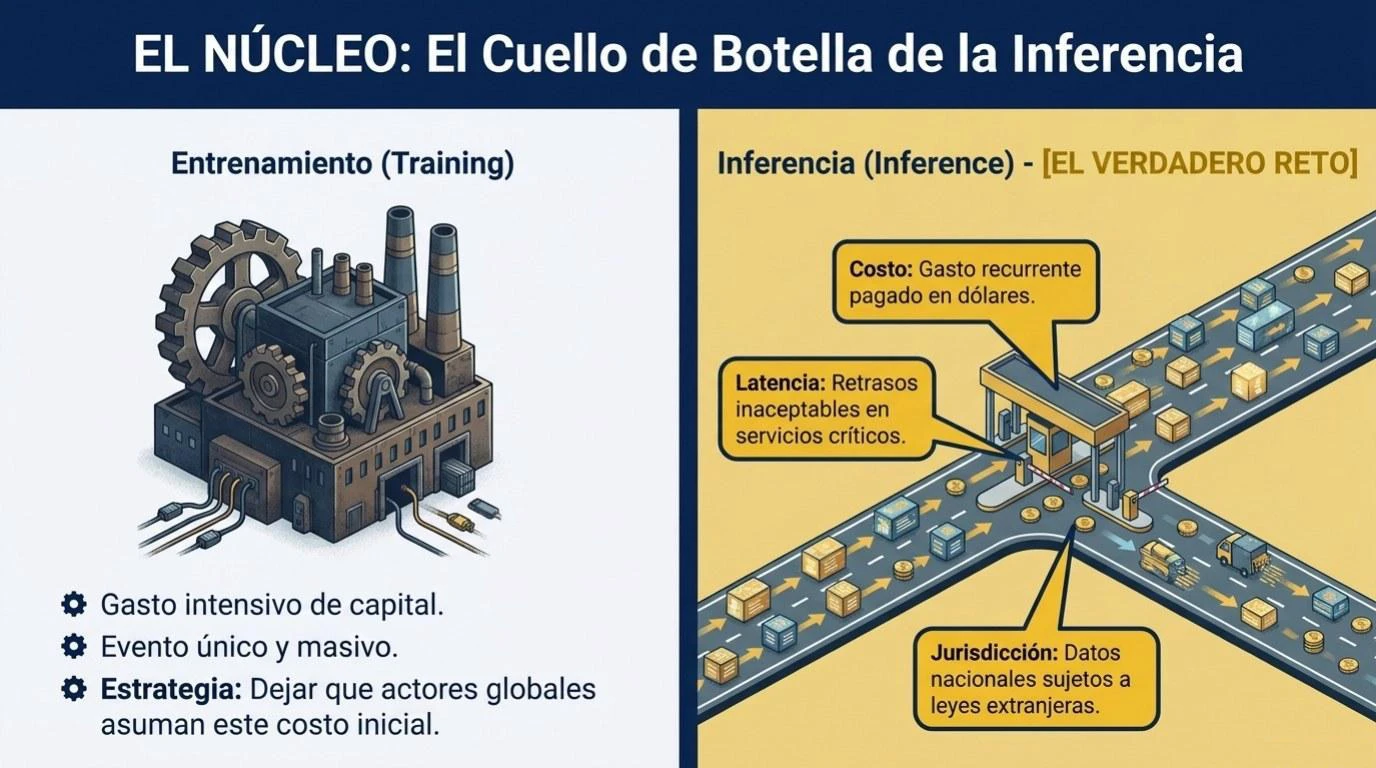
Los cinco pasos descritos deben aterrizar en una pieza concreta de arquitectura institucional: un clúster nacional de IA orientado a la inferencia. La distinción entre entrenamiento e inferencia es decisiva para un país como Ecuador. El entrenamiento de un modelo es un esfuerzo puntual, intensivo en capital, que solo unos pocos actores globales pueden costear. La inferencia, en cambio, es el uso cotidiano del modelo ya entrenado para responder consultas, y constituye un gasto recurrente que crece con cada usuario, cada institución y cada aplicación incorporada. Si el país adopta modelos de peso abierto (paso 2) y los adapta con datos propios (paso 3), el problema económico y técnico dominante dejará de ser entrenar y pasará a ser servir esos modelos de manera confiable, rápida, barata y bajo jurisdicción nacional. Esa es la esencia del problema de inferencia.
El problema tiene cuatro dimensiones. La primera es el costo: cada consulta procesada en la nube extranjera se paga, generalmente en divisas y bajo tarifas fijadas por el proveedor, lo que en una economía dolarizada como la ecuatoriana implica una salida sostenida de recursos y una exposición permanente a cambios de precios. La segunda es la latencia: los servicios alojados en regiones distantes añaden retrasos que degradan aplicaciones sensibles al tiempo, como la atención al ciudadano, la asistencia clínica o la videovigilancia. La tercera es la jurisdicción: cada consulta puede contener datos personales, institucionales o estratégicos que abandonan el territorio y quedan sujetos a normas ajenas. La cuarta es la continuidad: una interrupción del servicio, un cambio de condiciones o una restricción de acceso dejaría sin capacidad a los sistemas que dependen de él. Estas dimensiones reproducen, en el plano operativo, las preocupaciones sobre colonialismo digital y dependencia de infraestructura señaladas por Kwet (2019) y Ávila Pinto (2018).
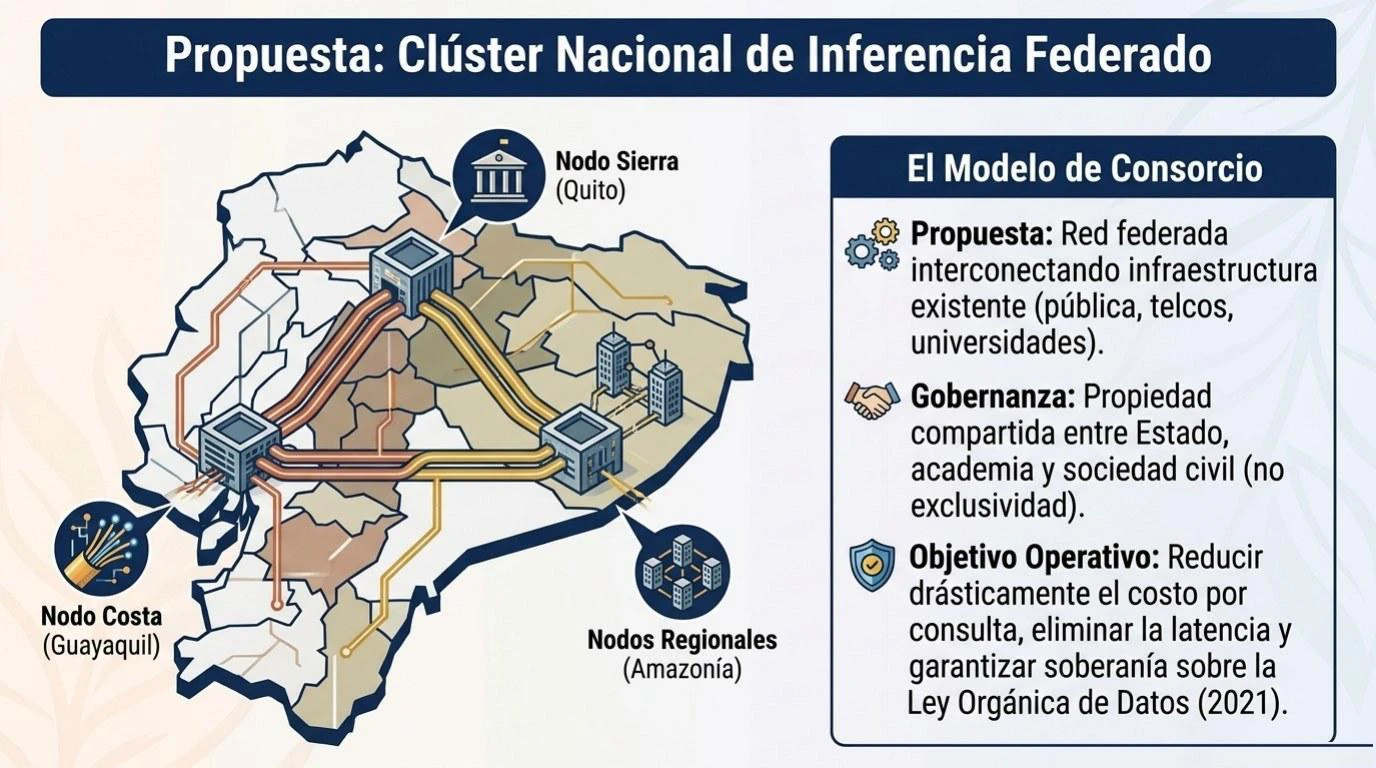
La respuesta propuesta es un clúster nacional de inferencia, concebido no como un único centro de datos sino como una red federada de nodos interconectados. Un primer nodo podría ubicarse en la región Costa, con Guayaquil como polo natural por su densidad económica y su conectividad internacional; un segundo, en la Sierra, en torno a Quito, donde se concentra la administración pública; y nodos universitarios y regionales adicionales podrían aportar capacidad distribuida y resiliencia. Esta arquitectura ofrece redundancia geográfica frente a fallas y desastres, acerca la capacidad de cómputo a los usuarios y permite que cada nodo se especialice según su entorno. El punto de partida natural es la infraestructura ya existente, incluida la fábrica de IA desplegada por Telconet para casos de uso locales como la seguridad urbana (IA de código abierto, s. f.), que podría integrarse a la red mediante acuerdos de interconexión y de acceso compartido, sin necesidad de duplicar inversiones.
En el plano técnico, el clúster debería operar como una plataforma de servicio de modelos. Alojaría un catálogo curado de modelos de peso abierto de distintos tamaños (Touvron et al., 2023), junto con variantes ajustadas para tareas nacionales mediante técnicas de adaptación eficiente (Hu et al., 2022) y con modelos pequeños soberanos como los propuestos en el marco MINGA-IA. Esta diversidad de escala es clave para la eficiencia: las tareas sencillas pueden resolverse con modelos livianos de bajo costo, reservando los modelos grandes para los casos que lo justifiquen. La plataforma ofrecería interfaces de programación estandarizadas, compatibles con los formatos de uso más extendidos, de modo que las instituciones puedan migrar aplicaciones existentes sin reescribirlas y, llegado el caso, volver a proveedores externos. Esta compatibilidad materializa el principio de opcionalidad tecnológica del quinto paso (IA de código abierto, s. f.).
La eficiencia operativa dependerá de prácticas de ingeniería como el procesamiento de solicitudes en lotes, el almacenamiento en caché de respuestas frecuentes, la reducción de la precisión numérica de los modelos para disminuir su consumo de memoria, y la asignación dinámica de recursos según la demanda. Estas técnicas permiten aumentar sustancialmente el número de consultas atendidas por unidad de hardware y, con ello, reducir el costo por consulta. Un clúster compartido consigue además una utilización más alta que la suma de infraestructuras aisladas: mientras una institución aislada tendría capacidad ociosa fuera de sus horas pico, un recurso común agrega demandas complementarias de universidades, hospitales, entidades públicas y empresas, y distribuye el costo fijo entre múltiples usuarios.
La ubicación de los nodos debe considerar la energía. La matriz eléctrica ecuatoriana, con fuerte participación hidroeléctrica, ofrece una ventaja potencial para alojar cómputo con menor huella de carbono, pero la vulnerabilidad del suministro ante sequías exige planificación. Los nodos deberían negociar contratos de suministro estables, incorporar respaldo energético y explorar la localización cerca de fuentes de generación. Bender et al. (2021) recuerdan que los costos ambientales de la IA son una responsabilidad ética y no una externalidad menor; la inferencia a escala nacional, aunque menos intensiva que el entrenamiento, se acumula y debe medirse y reportarse.
En cuanto a la gobernanza, el clúster no debería ser propiedad exclusiva del Estado ni del sector privado. Un modelo de consorcio, con participación de entidades públicas, universidades, operadores de telecomunicaciones, empresas y representantes de la sociedad civil, permitiría combinar financiamiento diverso, experticia técnica y legitimidad social. La compra pública puede actuar como cliente ancla, comprometiendo una demanda inicial que haga viable la inversión, mientras que un esquema de acceso escalonado ofrecería tarifas preferenciales a universidades y a emprendimientos pequeños. Los datos sensibles de salud, educación, justicia y seguridad se procesarían en nodos con controles reforzados, en cumplimiento de la Ley Orgánica de Protección de Datos Personales (Asamblea Nacional del Ecuador, 2021), y con registros auditables de acceso por parte de la autoridad competente.
El clúster enfrenta riesgos que deben reconocerse. El primero es la dependencia del hardware: los aceleradores de cómputo son producidos por un número muy reducido de fabricantes y están sujetos a cadenas de suministro globales y a restricciones comerciales. Cabe mitigar este riesgo con diversidad de proveedores de hardware, compatibilidad de las plataformas de software con distintas arquitecturas y una estrategia de renovación escalonada. El segundo es la operación por terceros: si el mantenimiento y la administración quedan íntegramente en manos de un proveedor extranjero, el clúster sería un caso de soberanía de fachada. Se requiere, por tanto, formar equipos nacionales de operación y exigir transferencia de conocimiento en cada contrato. El tercero es la subutilización: una infraestructura sin demanda, sin talento y sin aplicaciones se convierte en un gasto improductivo, lo que refuerza la necesidad de articular el clúster con los pasos de formación de talento y de adaptación al contexto local.
Para evaluar el desempeño del clúster se proponen indicadores propios: costo por millón de unidades de texto procesadas frente a alternativas externas, latencia promedio por región, porcentaje de utilización del hardware, proporción de cargas sensibles procesadas en territorio nacional, tiempo de recuperación ante fallas, número de instituciones y emprendimientos usuarios, y porcentaje del personal operativo de nacionalidad ecuatoriana. Estos indicadores permiten verificar que el clúster cumple su doble propósito: resolver el problema técnico y económico de la inferencia y fortalecer la capacidad de decisión del país.
Sección 6Paso 2: utilización de modelos de peso abierto y la ventaja del llegado tarde
El segundo paso responde a una realidad económica difícil de eludir: entrenar modelos de frontera desde cero requiere inversiones masivas de capital y de capacidad de cómputo que, para la mayoría de los países en desarrollo, están fuera de alcance en el corto plazo (IA de código abierto, s. f.). Frente a ello, la alternativa consiste en adoptar modelos de peso abierto, cuyos parámetros pueden descargarse, ejecutarse y adaptarse localmente conforme a sus respectivas licencias. Esta estrategia otorga a los países una ventaja de llegada tardía, pues les permite aplicar versiones recientes de las tecnologías directamente en los sectores donde poseen ventajas comparativas, sin enfrentar costos prohibitivos.
La lógica de esta propuesta se apoya en la tesis de Gerschenkron (1962) sobre las ventajas del atraso. Así como los países de industrialización tardía pudieron saltarse etapas tecnológicas adoptando técnicas ya probadas, un país como Ecuador puede aprovechar modelos desarrollados y perfeccionados por terceros para concentrar sus recursos en la aplicación y adaptación. La liberación de familias de modelos como Llama 2 (Touvron et al., 2023), que se acompañó de la publicación de sus pesos y de documentación técnica detallada, ejemplifica la disponibilidad de arquitecturas de alto rendimiento que pueden ser descargadas y ajustadas por terceros.
Es necesario, sin embargo, introducir precisiones. En primer lugar, no todo modelo de peso abierto es de código abierto en sentido estricto. Muchas licencias imponen restricciones de uso, de tamaño de usuarios o de finalidad, de modo que la apertura es un espectro y no una categoría binaria. Una estrategia nacional debe, por lo tanto, evaluar cuidadosamente los términos de cada licencia, priorizando aquellas que permiten el uso comercial, la modificación y la redistribución sin condiciones que comprometan la autonomía. En segundo lugar, la apertura de los pesos no implica necesariamente la apertura de los datos de entrenamiento ni de los procesos de alineamiento, de modo que persisten opacidades que pueden afectar la auditabilidad. En tercer lugar, la dependencia de un pequeño número de desarrolladores originarios, incluso si sus modelos son abiertos, puede generar una forma de dependencia tecnológica de segundo orden, en la que las decisiones sobre nuevas versiones, arquitecturas y licencias siguen siendo tomadas fuera del país.
Las técnicas de adaptación eficiente hacen que esta estrategia sea económicamente realista. Métodos como la adaptación de bajo rango (LoRA), que reducen sustancialmente el número de parámetros que deben ajustarse durante el afinamiento de un modelo, permiten personalizar modelos grandes con recursos de cómputo moderados (Hu et al., 2022). Ello abre la posibilidad de que universidades, empresas y entidades públicas ecuatorianas construyan variantes especializadas para el sector agrícola, la salud, la educación o los servicios financieros, sin necesidad de entrenar desde cero.
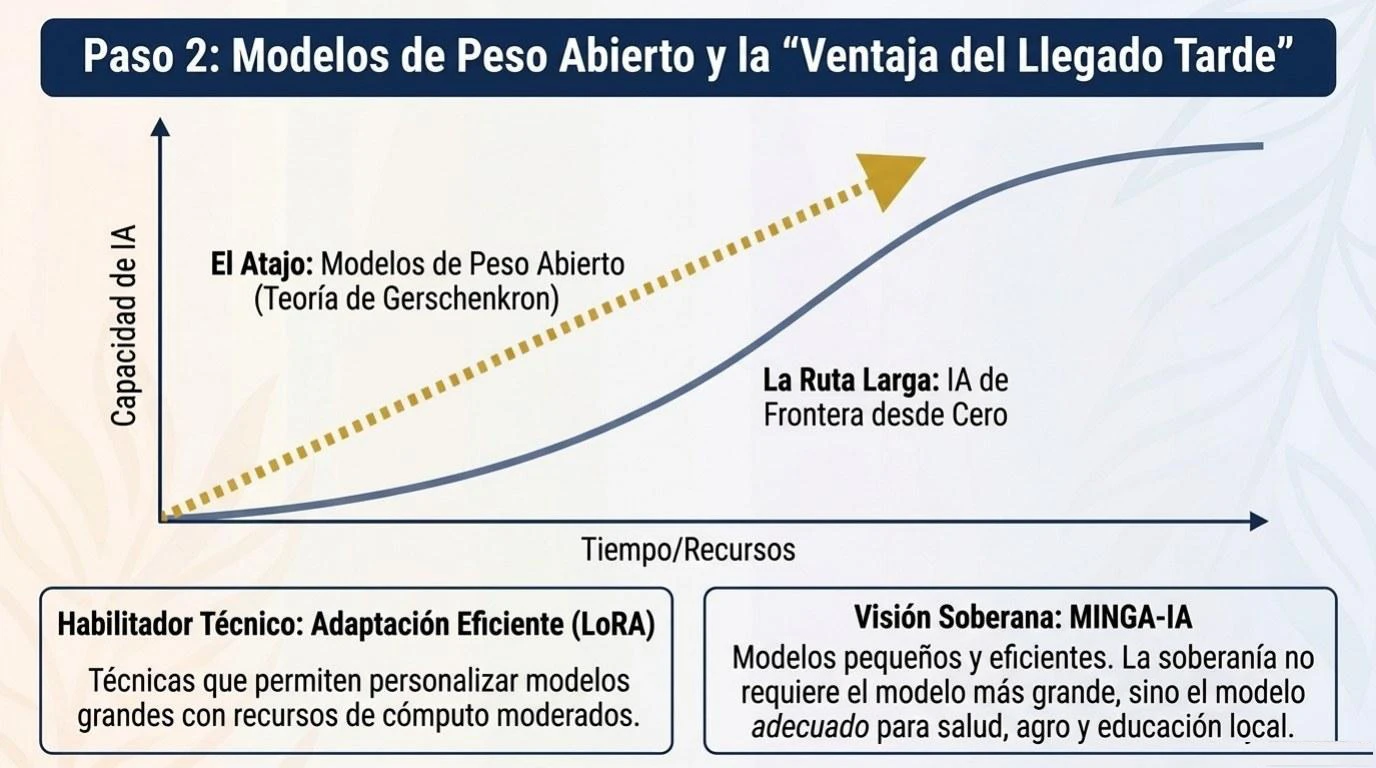
En este punto resulta pertinente introducir una consideración sobre la escala. Los modelos de lenguaje de menor tamaño, conocidos como modelos pequeños, pueden ser suficientes para muchas tareas específicas y ofrecen ventajas en costo, latencia, privacidad y facilidad de despliegue local. La propuesta MINGA-IA (Modelos Independientes de Nueva Generación Autónoma) se inscribe en esta línea al plantear el desarrollo de modelos pequeños soberanos, inspirados en la tradición andina del trabajo colectivo, como alternativa a la dependencia de grandes modelos extranjeros. La idea central es que la soberanía no requiere el modelo más grande, sino el modelo adecuado, gobernado por instituciones nacionales y adaptado a las necesidades del país. En el contexto de la educación superior ecuatoriana, por ejemplo, un modelo pequeño ajustado con corpus académicos locales y desplegado en infraestructura universitaria puede ofrecer asistencia pedagógica y de investigación sin exponer datos institucionales a proveedores externos.
Finalmente, el uso de modelos de peso abierto exige capacidades de evaluación. Un modelo que funciona bien en inglés o en pruebas estandarizadas puede comportarse de manera deficiente con variantes dialectales del español andino o costeño, con terminología jurídica ecuatoriana o con lenguas indígenas. Es indispensable, por tanto, desarrollar conjuntos de evaluación propios, que permitan medir el desempeño de los modelos en tareas relevantes para el país y detectar sesgos que las evaluaciones internacionales no capturan. Esta capacidad de evaluar constituye, en sí misma, una forma de soberanía epistémica.
Sección 7Paso 3: adaptación al contexto local y datos soberanos
El tercer paso sostiene que, para que la IA sea verdaderamente efectiva, su aplicación debe adaptarse al contexto local. Ello significa que los desarrolladores necesitan emplear datos propios para ajustar los modelos a las realidades culturales, lingüísticas y a las necesidades específicas del país (IA de código abierto, s. f.). Al gestionar el procesamiento de los datos dentro de infraestructuras ubicadas en el propio territorio, se asegura también que la información permanezca protegida bajo el control legal y jurisdiccional de la nación.
Este paso conecta directamente con las preocupaciones de la literatura crítica. Ricaurte (2019) advierte que los datos no son simples registros de la realidad, sino productos de relaciones sociales y de poder, y que las epistemologías que los organizan pueden invisibilizar o distorsionar los saberes locales. Birhane (2020) muestra que los sistemas entrenados con datos ajenos al contexto pueden producir errores sistemáticos cuando se despliegan en comunidades distintas a aquellas que los originaron. Adaptar la IA al contexto ecuatoriano exige, por tanto, construir corpus que reflejen la diversidad lingüística del país, sus variantes dialectales, su terminología técnica y jurídica, sus tradiciones culturales y sus conocimientos ancestrales.
La construcción de esos corpus plantea desafíos éticos y jurídicos considerables. Los conocimientos de los pueblos y nacionalidades indígenas no pueden tratarse como recursos libremente extraíbles; su recolección y uso debe basarse en el consentimiento libre, previo e informado, y en mecanismos de gobernanza colectiva que reconozcan la titularidad comunitaria sobre esos saberes. De lo contrario, la estrategia de datos soberanos correría el riesgo de reproducir, a escala nacional, la lógica extractivista que se pretende evitar. En el sentido de Couldry y Mejias (2019), no basta con trasladar la extracción de datos desde las corporaciones extranjeras hacia actores nacionales: es necesario transformar la relación misma entre las personas y sus datos.
El marco normativo ecuatoriano ofrece un punto de partida. La Constitución de la República reconoce el acceso a las tecnologías de la información y la comunicación como un derecho (Asamblea Constituyente del Ecuador, 2008, art. 16) y establece, entre los objetivos del sistema de ciencia, tecnología e innovación, el desarrollo de tecnologías que mejoren la calidad de vida y contribuyan al buen vivir (Asamblea Constituyente del Ecuador, 2008, art. 385). La Ley Orgánica de Protección de Datos Personales, publicada en 2021, establece principios, derechos y obligaciones para el tratamiento de datos personales y crea una autoridad de protección de datos (Asamblea Nacional del Ecuador, 2021). Estos instrumentos constituyen una base valiosa, aunque su eficacia dependerá de la capacidad institucional para supervisar su cumplimiento y de su articulación con normas sectoriales sobre salud, educación, seguridad y agricultura.
Un elemento clave de este paso es la distinción entre localización de datos y soberanía de datos. Alojar información en servidores ubicados en territorio nacional es una condición necesaria, pero no suficiente. La soberanía exige, además, control sobre los términos de acceso, capacidad de auditoría, reglas claras sobre reutilización secundaria y mecanismos que impidan la transferencia no autorizada. Ávila Pinto (2018) subraya que la soberanía digital no puede reducirse a una cuestión de ubicación física de los servidores, sino que depende de quién ejerce efectivamente el control sobre los sistemas y sobre las reglas que los gobiernan.
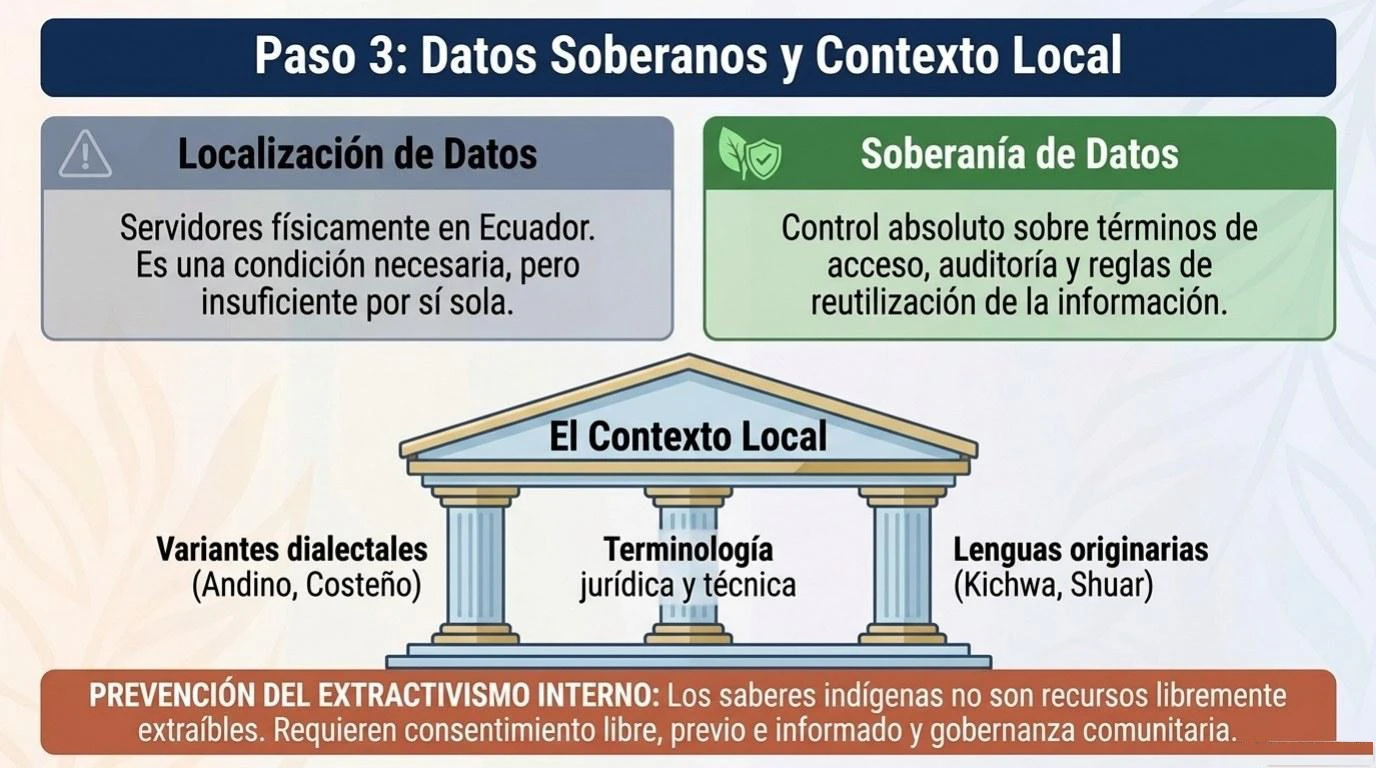
Para operacionalizar este paso se proponen cuatro medidas. Primero, la creación de repositorios nacionales de datos abiertos y curados, con estándares de calidad, anonimización y licenciamiento claros, en sectores prioritarios como salud pública, educación, agricultura y gestión territorial. Segundo, el desarrollo de protocolos de gobernanza comunitaria para los datos de pueblos y nacionalidades. Tercero, la adopción de técnicas de preservación de la privacidad, como el aprendizaje federado y la anonimización robusta, que permiten entrenar modelos sin centralizar datos sensibles. Cuarto, el fortalecimiento de la autoridad de protección de datos, con recursos técnicos y financieros adecuados para auditar sistemas de IA.
Sección 8Paso 4: capacitación y desarrollo del talento humano
El cuarto paso establece que desarrollar ecosistemas de IA exige inversiones directas en las habilidades de la fuerza laboral. Es imprescindible establecer marcos educativos sólidos e integrar cursos de IA y ciencia de datos en los planes de estudio existentes, junto con estrategias de mejora de habilidades (up-skilling), recapacitación (re-skilling) y capacitación transversal (cross-skilling), a fin de adaptar el talento humano a las posibles transformaciones del mercado laboral (IA de código abierto, s. f.). La infraestructura y los modelos son insuficientes si no existen personas capaces de operarlos, evaluarlos, adaptarlos y gobernarlos.
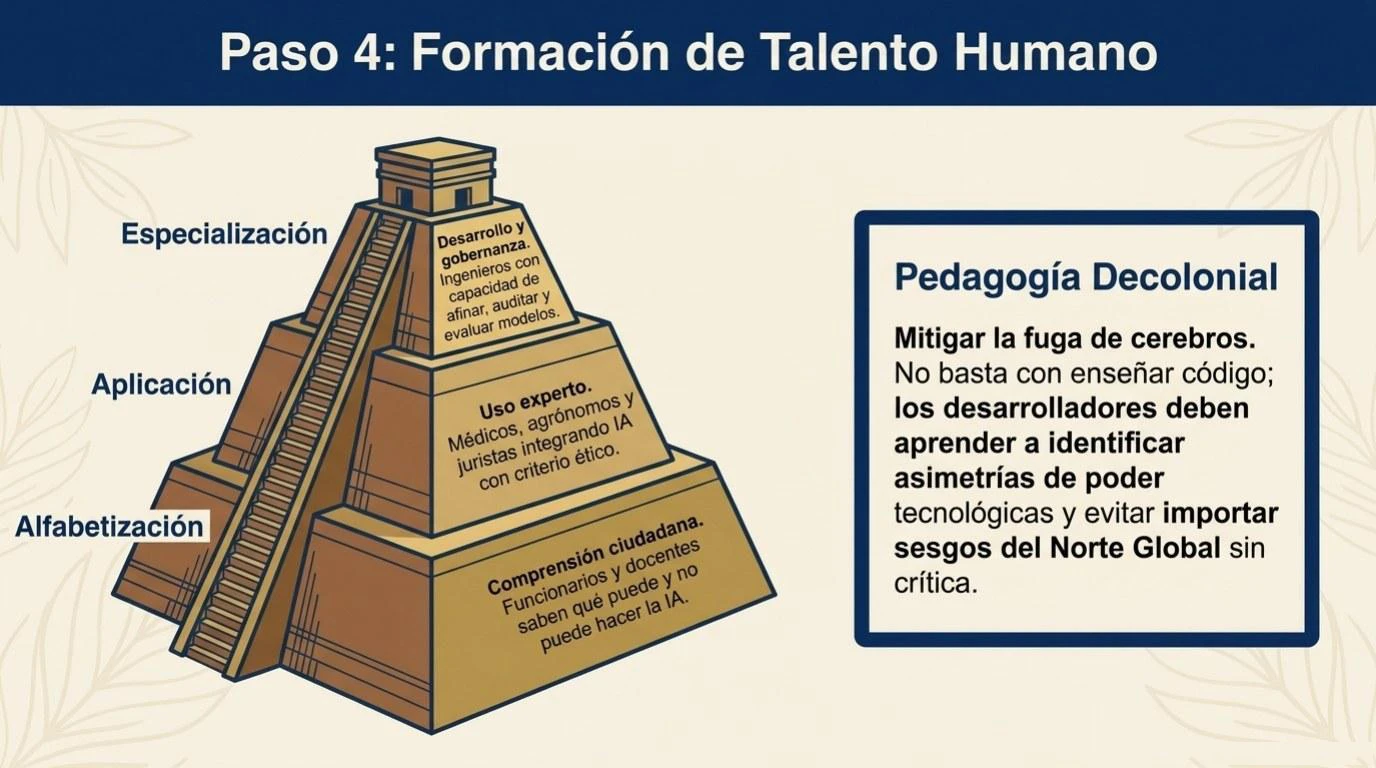
La formación de talento en IA enfrenta en Ecuador varios desafíos. El primero es la fuga de cerebros: los profesionales con competencias avanzadas en aprendizaje automático suelen encontrar mejores condiciones salariales y de investigación en el extranjero o en empresas transnacionales. El segundo es la brecha entre la oferta académica y las necesidades del sector productivo, que se traduce en egresados con conocimientos teóricos pero con limitada experiencia en el despliegue de sistemas reales. El tercero es la desigualdad territorial en el acceso a educación de calidad y a conectividad, que amenaza con reproducir en el ámbito de la IA las brechas históricas entre las áreas urbanas y rurales, y entre la Sierra, la Costa y la Amazonía.
Una estrategia de talento debe operar en al menos tres niveles. En el nivel de alfabetización, se trata de que la población en general, y en particular docentes, funcionarios públicos y emprendedores, comprenda qué es la IA, qué puede y qué no puede hacer, y cuáles son sus riesgos. En el nivel de aplicación, se busca formar profesionales de diferentes disciplinas, como médicos, docentes, ingenieros agrónomos, juristas y comunicadores, capaces de integrar herramientas de IA en su práctica con criterio ético y técnico. En el nivel de especialización, se requiere formar investigadores e ingenieros con capacidad de afinar, evaluar y desplegar modelos, así como especialistas en gobernanza y ética de la IA. La Recomendación sobre la ética de la inteligencia artificial de la UNESCO (2021) proporciona un marco normativo de referencia que subraya la importancia de la educación, la alfabetización y el desarrollo de capacidades como condiciones para una IA centrada en las personas.
El papel de las universidades es central. Estas instituciones pueden actuar como nodos de un ecosistema nacional, al alojar infraestructura compartida, desarrollar corpus y modelos abiertos, formar talento y servir de puente con el sector productivo y el Estado. En el ámbito de la educación virtual, además, la IA plantea oportunidades y riesgos específicos: puede ampliar el acceso, personalizar el aprendizaje y apoyar a los docentes, pero también puede introducir sesgos, deteriorar la autonomía intelectual de los estudiantes y trasladar datos educativos a plataformas extranjeras. Un modelo que combine tutores basados en modelos pequeños locales con supervisión docente puede equilibrar estas tensiones.
La perspectiva decolonial añade una dimensión pedagógica que no debe pasarse por alto. Formar talento en IA no consiste únicamente en transferir competencias técnicas, sino en cultivar una mirada crítica sobre los supuestos que incorporan las tecnologías. Mohamed et al. (2020) proponen que los profesionales de la IA desarrollen una sensibilidad hacia las relaciones de poder que atraviesan su trabajo, y Santos (2014) llama a reconocer la pluralidad de saberes. Integrar contenidos de ética, de historia de la tecnología y de saberes locales en los currículos de IA contribuye a formar profesionales capaces de innovar sin reproducir acríticamente los modelos hegemónicos.
Finalmente, retener talento exige condiciones. Los programas de formación deben acompañarse de oportunidades de investigación y desarrollo dentro del país, de mecanismos de financiamiento para proyectos de IA de interés público, de incentivos para el retorno de profesionales formados en el exterior y de redes de colaboración que permitan a los investigadores ecuatorianos integrarse a comunidades científicas globales sin abandonar el territorio. La cooperación internacional, tema del siguiente paso, es también una herramienta de retención de talento cuando se diseña con criterios de reciprocidad.
Sección 9Paso 5: cooperación internacional y opcionalidad tecnológica
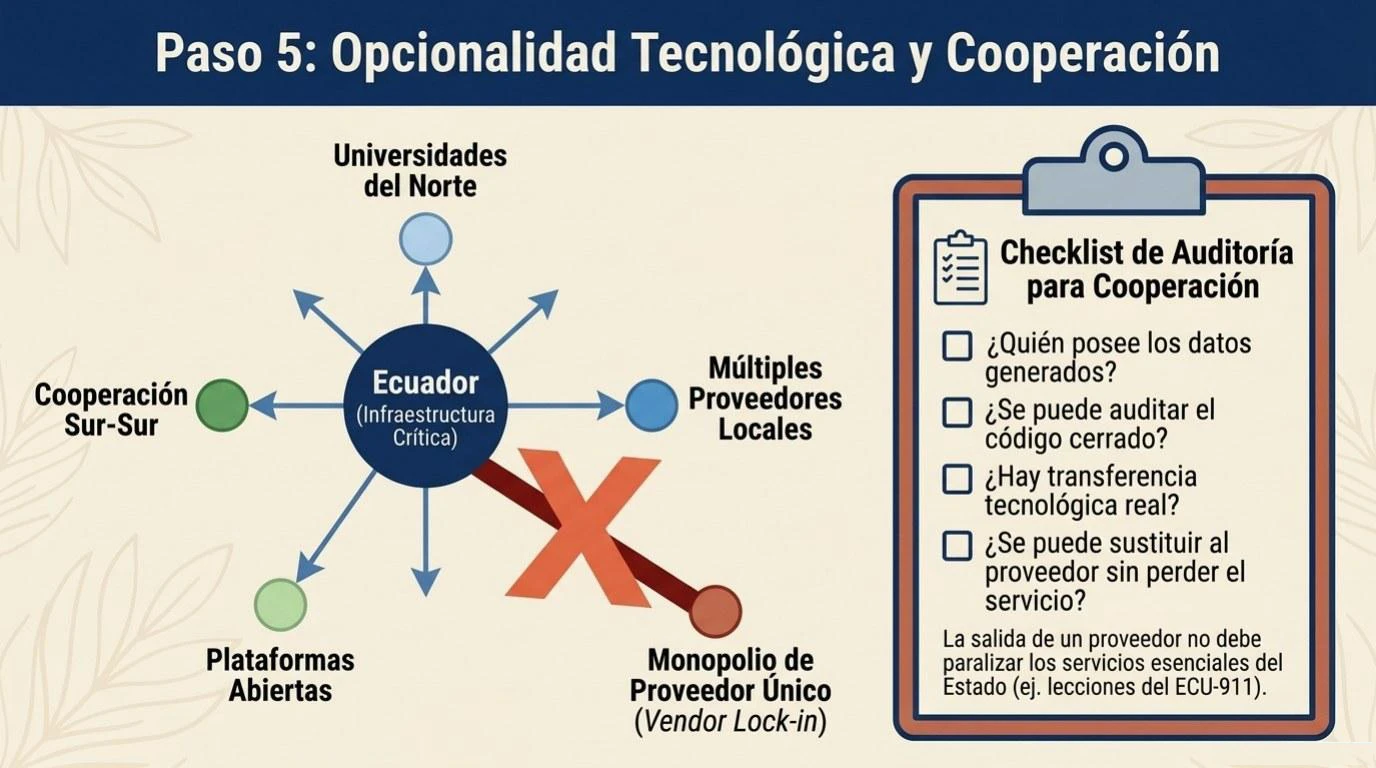
El quinto paso plantea que, para lograr un avance sostenido, es necesario fomentar asociaciones interregionales y globales de investigación y desarrollo que permitan combinar recursos y compartir riesgos. Adicionalmente, el país debe adquirir modelos y servicios en la nube de diversos orígenes, de modo que funcionen entre sí y puedan ser reemplazados si fuera necesario. La interoperabilidad resulta crucial para que las naciones del Sur Global eviten la dependencia de proveedores únicos, ya sean de Estados Unidos o de China (IA de código abierto, s. f.).
Este paso introduce el concepto de opcionalidad tecnológica, que puede definirse como la capacidad de un país de mantener abiertas múltiples alternativas técnicas y comerciales, de modo que la salida de un proveedor no comprometa la continuidad de sus servicios esenciales. La opcionalidad es una forma práctica de soberanía: no exige autarquía, sino reducción de los costos de cambio. En términos de diseño institucional, implica exigir estándares abiertos, formatos de datos portables, interfaces documentadas y cláusulas contractuales de salida, así como evitar que un único proveedor controle simultáneamente la infraestructura, el modelo y los datos.
La referencia a la dependencia de proveedores de Estados Unidos o de China es particularmente relevante en el contexto de la rivalidad tecnológica entre ambas potencias. Ecuador, como muchos países de la región, mantiene relaciones comerciales, financieras y tecnológicas con ambos polos. El riesgo no reside en la relación con uno u otro, sino en la construcción de dependencias exclusivas que limiten la autonomía de decisión. La diversificación de proveedores, complementada con capacidades técnicas propias para evaluar y auditar sus productos, es la respuesta más prudente ante ese escenario.
La cooperación internacional puede adoptar múltiples formas. La cooperación Sur-Sur, con países de América Latina, África y Asia que enfrentan desafíos similares, permite compartir corpus, modelos, metodologías de evaluación y experiencias de gobernanza. La cooperación con centros de investigación y universidades del Norte puede aportar acceso a conocimiento de frontera, siempre que se estructure con criterios de reciprocidad y de propiedad compartida de los resultados. La participación en foros multilaterales, como los promovidos por la UNESCO (2021), permite incidir en la formulación de estándares globales, en lugar de limitarse a acatarlos. En el ámbito regional, las asociaciones con países vecinos pueden facilitar la construcción de infraestructura compartida y de corpus del español latinoamericano y de lenguas originarias transfronterizas como el kichwa.
La cooperación, sin embargo, no es neutral. Puede convertirse en un vehículo de dependencia cuando las contrapartes aportan tecnología a cambio de acceso privilegiado a datos, cuando los proyectos conjuntos carecen de cláusulas de transferencia tecnológica o cuando los términos de propiedad intelectual favorecen sistemáticamente a una de las partes. Por ello, cada acuerdo debe evaluarse a la luz de una lista mínima de preguntas: ¿quién posee los datos generados?, ¿quién puede auditar el sistema?, ¿existe transferencia de conocimiento efectiva?, ¿puede el país prescindir del socio sin pérdida de continuidad?, ¿se respetan los principios de protección de datos y de derechos humanos?
Mozur et al. (2019) documentaron cómo empresas chinesas exportaron a diversos países sistemas de vigilancia y control basados en tecnologías digitales, con financiamiento asociado a paquetes de cooperación, lo que ilustra los riesgos que puede entrañar la adquisición de sistemas cerrados y llave en mano sin capacidad local de auditoría. El caso de Ecuador y su sistema integrado de seguridad ECU-911 es frecuentemente mencionado en ese contexto. La lección relevante no es que la tecnología de un país específico deba ser rechazada, sino que ningún sistema de importancia estratégica debería adoptarse sin cláusulas de auditoría, sin comprensión de los flujos de datos y sin alternativas técnicas de reemplazo.
Sección 10Tensiones y riesgos: hacia la superación de la soberanía de fachada
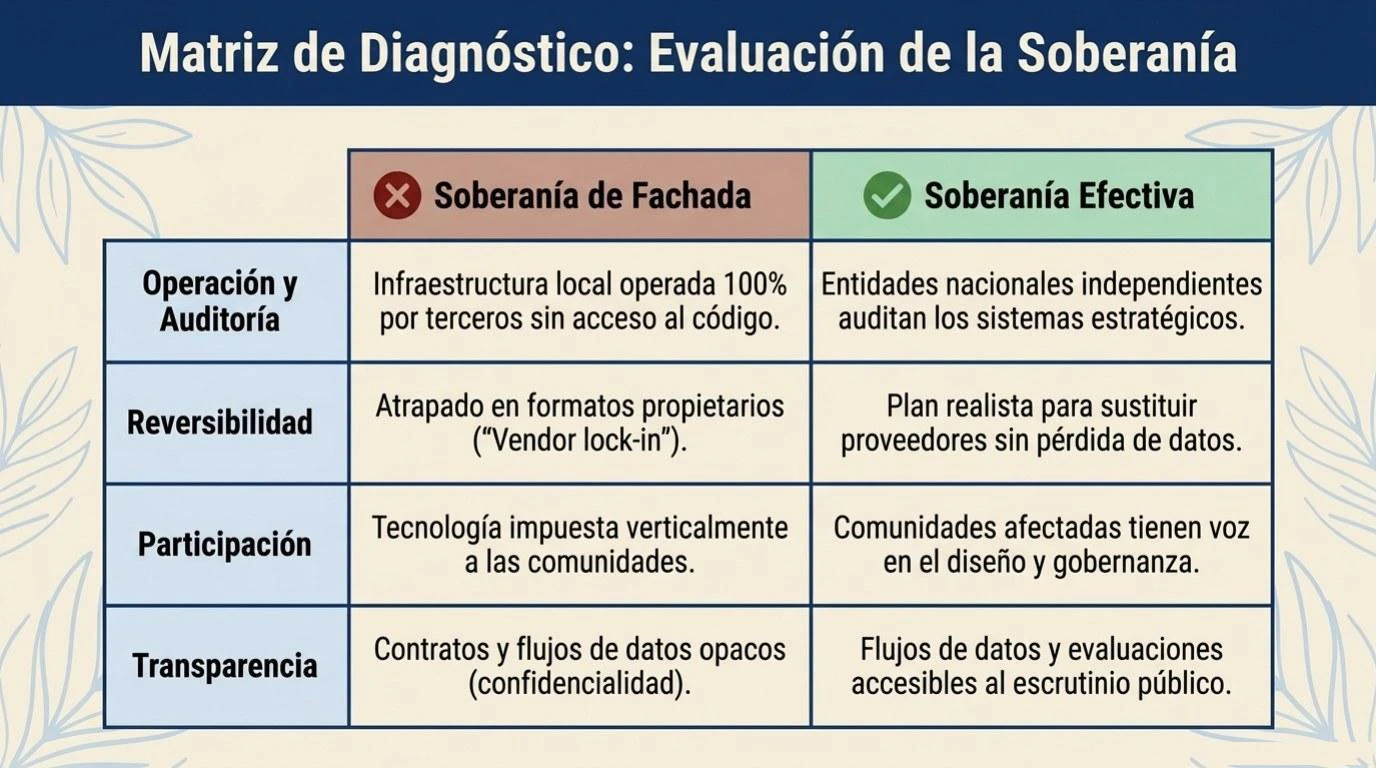
Un análisis honesto de los cinco pasos debe reconocer que ninguno es suficiente por sí mismo y que cada uno puede degenerar en su contrario. La infraestructura local puede convertirse en un enclave operado por terceros; los modelos abiertos, en una dependencia de licencias revocables; los datos soberanos, en un nuevo espacio de extracción; la formación de talento, en una cantera para la fuga de cerebros; y la cooperación internacional, en una relación asimétrica encubierta. A esta posibilidad puede denominarse soberanía de fachada: una situación en la que los símbolos y las estructuras formales de la soberanía existen, pero el control efectivo sobre las decisiones críticas reside en otros actores.
La soberanía de fachada se manifiesta cuando la infraestructura se ubica físicamente en el país pero su operación, mantenimiento y actualización dependen íntegramente de un proveedor extranjero; cuando existen leyes de protección de datos sin autoridad con capacidad de aplicarlas; cuando los modelos se adoptan sin capacidad local para evaluarlos; o cuando los contratos de cooperación otorgan a las contrapartes un acceso amplio a información estratégica. La experiencia de los sistemas de vigilancia adquiridos mediante paquetes tecnológicos cerrados es ilustrativa de la brecha que puede existir entre la propiedad nominal de una infraestructura y el control efectivo sobre sus datos y sus algoritmos (Mozur et al., 2019).
Frente a estos riesgos, la literatura ofrece algunas orientaciones. Mohamed et al. (2020) proponen técnicas decoloniales como la construcción de comunidades críticas de práctica, la atención a las asimetrías de poder en los procesos de diseño y la participación de las comunidades afectadas en la gobernanza de los sistemas. Kwet (2019) enfatiza la necesidad de desarrollar alternativas basadas en software libre y en infraestructuras comunitarias como condición para una autonomía real. Couldry y Mejias (2019) subrayan que las respuestas no pueden limitarse al plano técnico, sino que deben incluir movilización social y regulación democrática.
A partir de estas orientaciones, pueden formularse cuatro criterios de verificación para evitar la soberanía de fachada. El primero es el criterio de auditabilidad: toda tecnología de importancia estratégica debe poder ser auditada técnicamente por entidades nacionales independientes. El segundo es el criterio de reversibilidad: debe existir un plan realista para sustituir a cualquier proveedor en un plazo razonable y sin pérdida de datos. El tercero es el criterio de participación: las comunidades afectadas por los sistemas de IA deben tener voz en su diseño y gobernanza. El cuarto es el criterio de transparencia: los contratos, los flujos de datos y las evaluaciones de impacto deben ser accesibles al escrutinio público, con las salvaguardas necesarias para la seguridad nacional.
Sección 11Hoja de ruta integrada para Ecuador
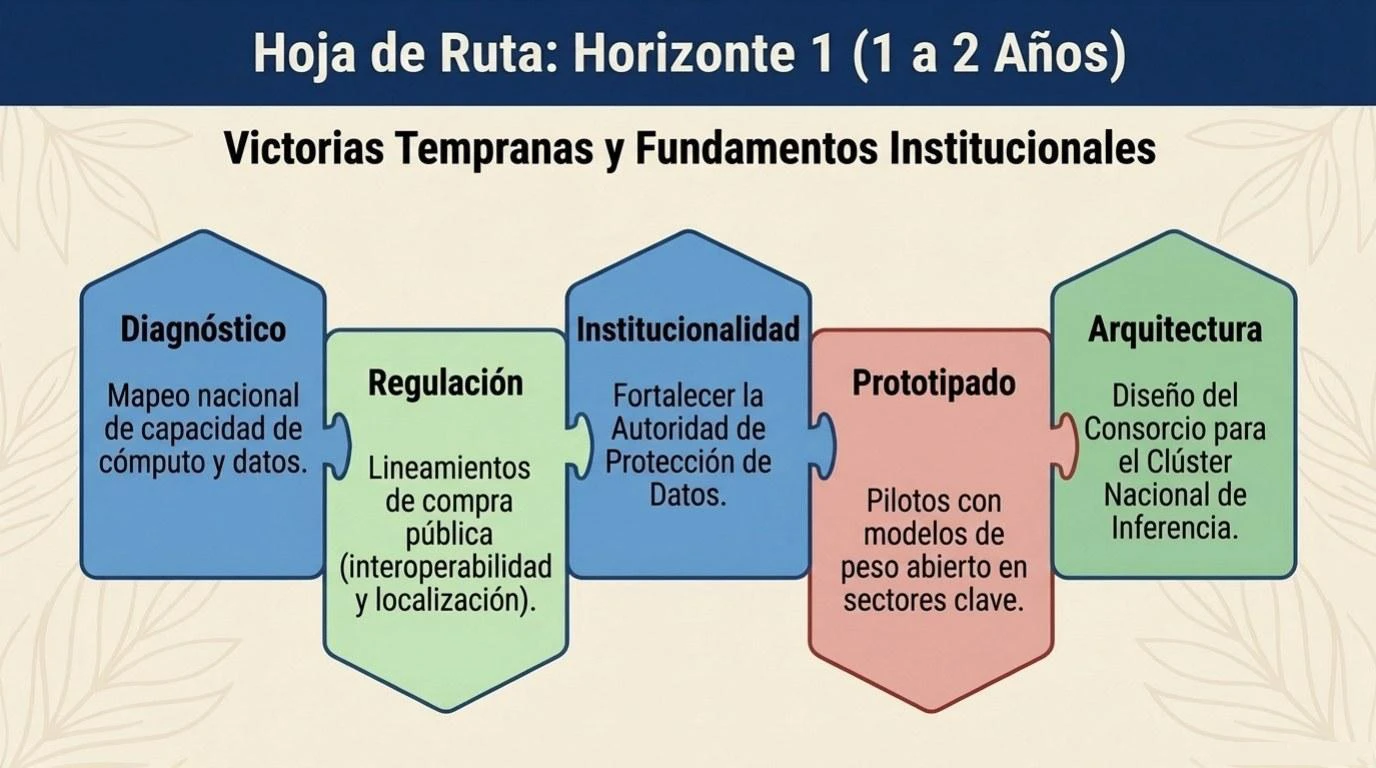
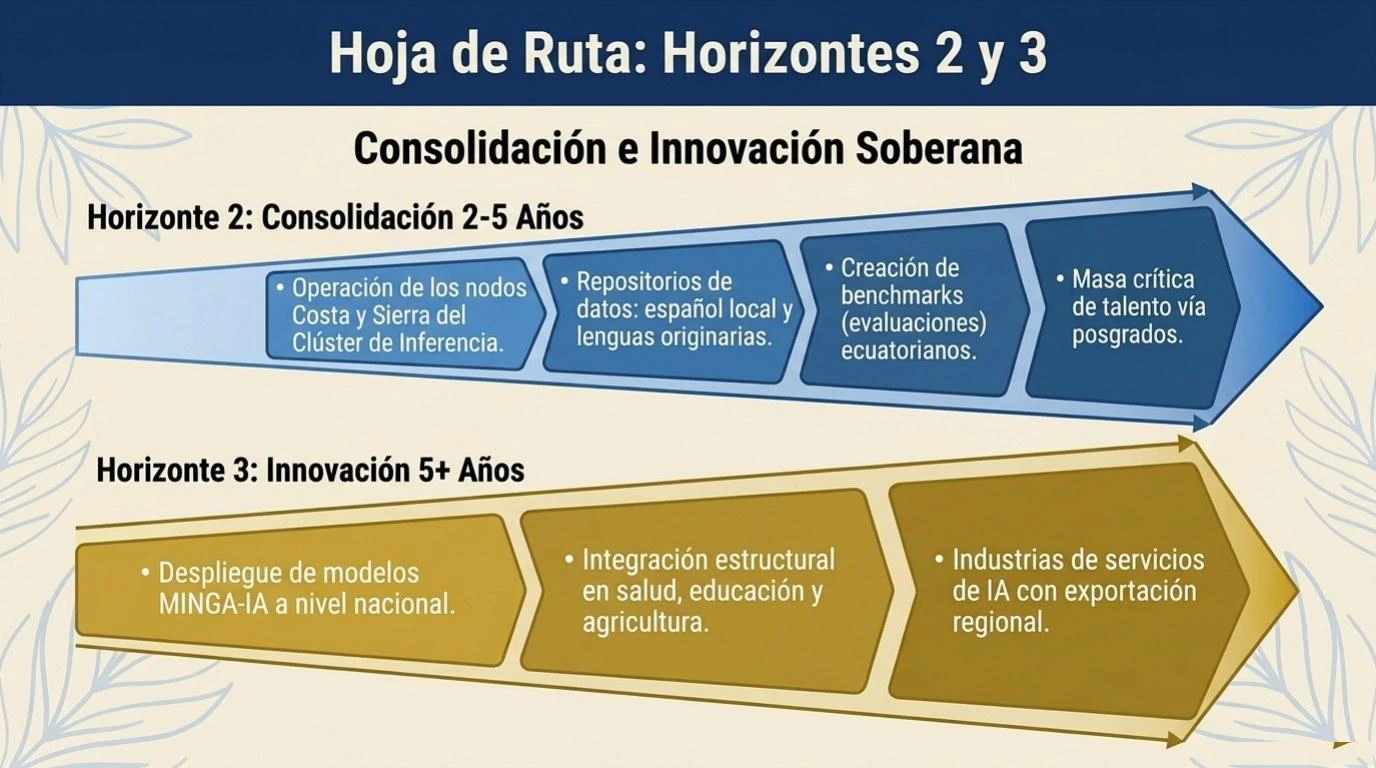
Los cinco pasos analizados pueden articularse en una hoja de ruta escalonada en tres horizontes temporales. Esta propuesta no pretende ser una prescripción cerrada, sino un ejercicio de ordenamiento que permita priorizar acciones y evaluar avances.
En el corto plazo, de uno a dos años, las prioridades deben centrarse en construir fundamentos institucionales y en generar victorias tempranas de bajo costo. Ello implica realizar el mapeo de la capacidad de cómputo instalada y de los datos disponibles; establecer lineamientos de compra pública que incorporen criterios de interoperabilidad, portabilidad y localización de datos sensibles; fortalecer a la autoridad de protección de datos; seleccionar un conjunto reducido de modelos de peso abierto para pruebas piloto en sectores prioritarios; diseñar el modelo de consorcio y la arquitectura del clúster nacional de inferencia, iniciando con la interconexión de infraestructura existente; y lanzar programas de alfabetización en IA para docentes y funcionarios públicos. En este horizonte, la ventaja de la adopción de modelos abiertos es más evidente, pues permite obtener resultados con inversiones moderadas.
En el mediano plazo, de dos a cinco años, corresponde consolidar capacidades. Ello supone desarrollar repositorios nacionales de datos y corpus en español y lenguas originarias, con protocolos de gobernanza comunitaria; poner en operación los nodos del clúster de inferencia en la Costa y la Sierra, con acceso compartido para universidades y centros de investigación; crear conjuntos de evaluación propios para medir el desempeño de los modelos en el contexto ecuatoriano; y formar una masa crítica de especialistas mediante programas de posgrado, becas y redes de cooperación. Es también el momento de construir alianzas Sur-Sur y de participar activamente en foros multilaterales, con el fin de incidir en la definición de estándares y de compartir recursos.
En el largo plazo, a partir de los cinco años, el objetivo es la consolidación de un ecosistema nacional con capacidad de innovación propia. Ello puede incluir el desarrollo de modelos pequeños soberanos, entrenados o ajustados con datos nacionales y desplegados en el clúster nacional de inferencia, en línea con propuestas como MINGA-IA; la creación de industrias de servicios de IA con proyección regional; y la integración de la IA en los sistemas de salud, educación, agricultura y gestión pública, con mecanismos permanentes de evaluación, auditoría y participación ciudadana.
Para que esta hoja de ruta sea efectiva, se requieren mecanismos de gobernanza que coordinen a los distintos actores. Una posibilidad es la creación de una instancia interinstitucional, con representación del Estado, las universidades, el sector privado, la sociedad civil y las organizaciones de pueblos y nacionalidades, encargada de definir prioridades, supervisar avances y publicar informes periódicos de seguimiento. Sin una instancia de este tipo, existe el riesgo de que las iniciativas se fragmenten, se dupliquen o queden sujetas a los ciclos políticos.
Es necesario, asimismo, definir indicadores que permitan evaluar el progreso en términos de soberanía efectiva y no solamente de adopción. Entre ellos pueden considerarse la proporción de datos sensibles procesados en infraestructura nacional, el número de proveedores por categoría crítica, el tiempo estimado de sustitución de un proveedor, el número de sistemas de IA de uso público sometidos a auditoría independiente, la disponibilidad de corpus en lenguas originarias, el número de profesionales formados y retenidos en el país, y el porcentaje de contratos públicos de tecnología que incluyen cláusulas de interoperabilidad y salida. Estos indicadores desplazan la evaluación desde la pregunta de cuánta IA se usa hacia la pregunta de quién decide sobre ella.
ConclusionesConclusiones
Este ensayo ha argumentado que Ecuador puede construir un ecosistema de IA significativo sin necesidad de competir en la carrera por los modelos de frontera. La combinación de infraestructura selectiva, modelos de peso abierto, datos soberanos, talento humano y cooperación diversificada constituye una estrategia realista, coherente con las condiciones económicas del país y con la ventaja del llegado tarde descrita por Gerschenkron (1962). Al aprovechar arquitecturas abiertas y ecosistemas colaborativos, es posible diagnosticar enfermedades, hacer crecer pequeñas empresas y mejorar servicios públicos de manera acelerada (IA de código abierto, s. f.).
El análisis ha mostrado, además, que la dimensión técnica de la adopción de IA es inseparable de su dimensión política. La literatura sobre colonialismo digital, extractivismo de datos y decolonialidad (Couldry y Mejias, 2019; Kwet, 2019; Mohamed et al., 2020; Quijano, 2000; Ricaurte, 2019) enseña que las tecnologías no son neutrales y que su adopción puede reproducir asimetrías históricas si no se acompaña de capacidades institucionales, de gobernanza democrática y de diversificación deliberada. La noción de soberanía de fachada alerta precisamente sobre este riesgo: la existencia de infraestructura nacional, leyes y discursos de soberanía no equivale, por sí sola, a control efectivo.
De aquí se derivan cuatro recomendaciones. Primera, crear un clúster nacional de inferencia de gobernanza consorciada, que reduzca el costo, la latencia y la exposición jurisdiccional de servir modelos desde el exterior. Segunda, tratar la interoperabilidad, la portabilidad y la auditabilidad como requisitos de política pública y no como preferencias técnicas, incorporándolas en la compra pública y en la regulación sectorial. Tercera, invertir de manera sostenida en capacidades humanas e institucionales, en particular en evaluación de modelos, gobernanza de datos y formación crítica, pues sin ellas la infraestructura y los modelos abiertos serán insuficientes. Cuarta, abordar la construcción de corpus y modelos locales con criterios de justicia epistémica, reconociendo la titularidad colectiva de los saberes de los pueblos y nacionalidades y evitando que la estrategia de datos soberanos reproduzca la lógica extractivista que busca superar.
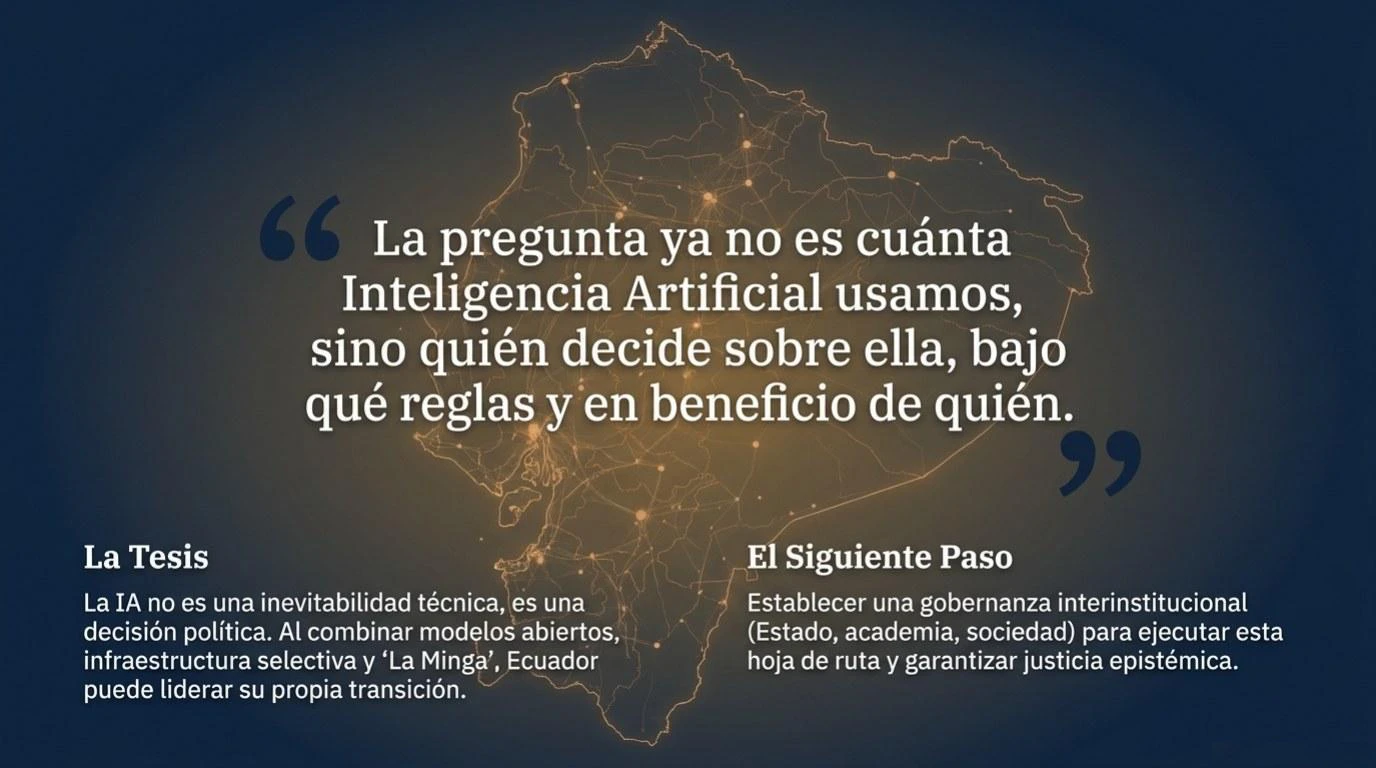
En definitiva, construir una infraestructura de IA para Ecuador no requiere avanzar hacia la creación de los modelos más grandes del mundo en el corto plazo. La clave reside en fortalecer los complementos analógicos y digitales, y en adaptar las herramientas disponibles a la realidad nacional con cuidado, pero sin demora (IA de código abierto, s. f.). La tarea es, en última instancia, política: decidir colectivamente qué tecnología se quiere, para qué, bajo qué reglas y en beneficio de quién.
FuentesReferencias
Cómo citar este ensayo
Chong Pineda, M. (2026). Pasos para la creación y adopción de inteligencia artificial en Ecuador: un enfoque desde el Sur Global [Ensayo académico]. Centro de Estudios en Estrategia y Políticas Públicas (CEEYPP). https://ceeypp.org/informes/pasos-ia-ecuador-sur-global/
- Asamblea Constituyente del Ecuador. (2008). Constitución de la República del Ecuador. Registro Oficial 449.
- Asamblea Nacional del Ecuador. (2021). Ley Orgánica de Protección de Datos Personales. Registro Oficial Suplemento 459.
- Ávila Pinto, R. (2018). Digital sovereignty or digital colonialism? Sur – International Journal on Human Rights, 15(27), 15–27.
- Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? En Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency (pp. 610–623). Association for Computing Machinery. https://doi.org/10.1145/3442188.3445922
- Birhane, A. (2020). Algorithmic colonization of Africa. SCRIPTed, 17(2), 389–409. https://doi.org/10.2966/scrip.170220.389
- Bommasani, R., Hudson, D. A., Adeli, E., Altman, R., Arora, S., von Arx, S., ... Liang, P. (2021). On the opportunities and risks of foundation models. arXiv. https://doi.org/10.48550/arXiv.2108.07258
- Couldry, N., & Mejias, U. A. (2019). The costs of connection: How data is colonizing human life and appropriating it for capitalism. Stanford University Press.
- Gerschenkron, A. (1962). Economic backwardness in historical perspective: A book of essays. Belknap Press of Harvard University Press.
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., & Chen, W. (2022). LoRA: Low-rank adaptation of large language models. En International Conference on Learning Representations. https://doi.org/10.48550/arXiv.2106.09685
- IA de código abierto: Nueva oportunidad para el Sur Global. (s. f.). [Documento de referencia sin publicar].
- Kwet, M. (2019). Digital colonialism: US empire and the new imperialism in the Global South. Race & Class, 60(4), 3–26. https://doi.org/10.1177/0306396818823172
- Mohamed, S., Png, M.-T., & Isaac, W. (2020). Decolonial AI: Decolonial theory as sociotechnical foresight in artificial intelligence. Philosophy & Technology, 33(4), 659– 684. https://doi.org/10.1007/s13347-020-00405-8
- Mozur, P., Kessel, J. M., & Chan, M. (2019, 24 de abril). Made in China, exported to the world: The surveillance state. The New York Times.
- Quijano, A. (2000). Colonialidad del poder, eurocentrismo y América Latina. En E. Lander (Ed.), La colonialidad del saber: eurocentrismo y ciencias sociales. Perspectivas latinoamericanas (pp. 201–246). CLACSO.
- Ricaurte, P. (2019). Data epistemologies, the coloniality of power, and resistance. Television & New Media, 20(4), 350–365. https://doi.org/10.1177/1527476419831640
- Santos, B. de S. (2014). Epistemologies of the South: Justice against epistemicide. Routledge.
- Srnicek, N. (2017). Platform capitalism. Polity Press.
- Touvron, H., Martin, L., Stone, K., Albert, P., Almahairi, A., Babaei, Y., ... Scialom, T. (2023). Llama 2: Open foundation and fine-tuned chat models. arXiv. https://doi.org/10.48550/arXiv.2307.09288
- UNESCO. (2021). Recomendación sobre la ética de la inteligencia artificial. https://unesdoc.unesco.org/ark:/48223/pf0000381137_spa
- Zuboff, S. (2019). The age of surveillance capitalism: The fight for a human future at the new frontier of power. PublicAffairs.